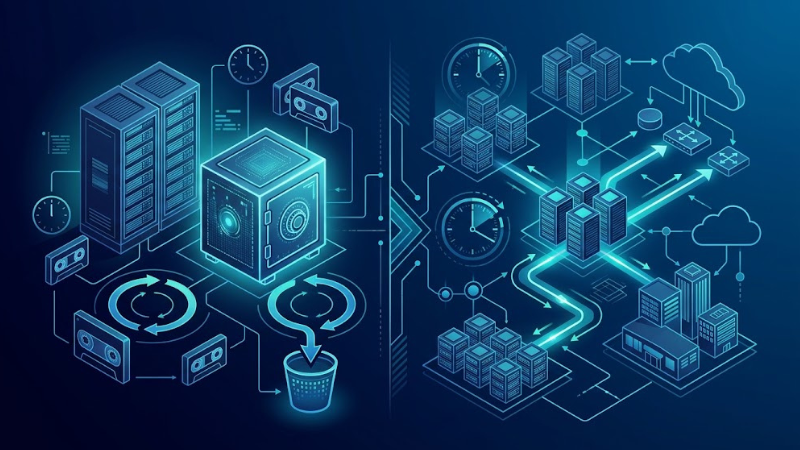
از دست رفتن دیتابیس یا نابودی یک نود در محیط پروداکشن، سناریوی دلهرهآوری است؛ اما فاجعه اصلی زمانی رخ میدهد که تیم زیرساخت متوجه میشود فایلهای پشتیبان برای بازگرداندن فوری کل سرویس به مدار کافی نیستند. دقیقاً در همین نقطه بحرانی است که درک تفاوت Backup و Disaster Recovery به یک تصمیم حیاتی در معماری سیستم تبدیل میشود. بسیاری از سازمانها با تصور داشتن نسخههای پشتیبان منظم، در برابر قطعیهای سطح دیتاسنتر یا حملات سایبری احساس امنیت کاذب میکنند.
در این مقاله از دواپس ایران، مرز دقیق این دو مفهوم، چالشهای بازگردانی سرویس، شاخصهای کلیدی RPO و RTO و نحوه پیادهسازی اصولی آنها در محیطهای ابری را از منظر مهندسی بررسی میکنیم. با مطالعه این متن، میتوانید استراتژی تابآوری سازمان خود را بر پایه واقعیتهای عملیاتی و تضمین آپتایم طراحی کنید، نه صرفاً انباشت دادهها.
Backup چیست و چه کاربردی دارد؟
در معماری سیستم، درک اینکه بکاپ چیست به معنای تهیه کپی ایزوله از دادهها (نظیر Snapshot دیسکها یا Dump دیتابیس) در یک نقطه زمانی (Point-in-Time) مشخص است. هدف این فرآیند، محافظت از State سیستم در برابر خطاهای انسانی، خرابی منطقی دادهها (Data Corruption)، باگهای نرمافزاری یا حملات باجافزاری است.
در محیطهای Production، این اقدام یک فرآیند منفعلانه و مبتنی بر داده است که معمولاً روی فضاهای ذخیرهسازی ارزانتر و باثبات (مانند Object Storage) بر اساس سیاستهای نگهداری (Retention Policies) پیادهسازی میشود.
کاربردهای اصلی Backup در عملیات روزمره زیرساخت شامل موارد زیر است:
- بازیابی دادههای از دست رفته: برگرداندن Table حذفشده دیتابیس یا بازیابی فایلهای پاکشده Volumeها بدون نیاز به تغییر معماری شبکه.
- بازگردانی به وضعیت پایدار: Rollback کردن دیتابیس یا تنظیمات کانفیگ پس از یک دپلوی (Deploy) یا مایگریشن ناموفق.
- حفظ سوابق (Compliance): آرشیو بلندمدت لاگهای سیستمی، رکوردهای مالی یا دیتای کاربران جهت پاسخگویی به الزامات قانونی.
محدودیت کلیدی (Trade-off):
بکاپگیری صرفاً دیتا را نجات میدهد، نه کل سرویس را. اگر کلاستر کوبرنیتیز یا روترهای لبه شبکه به دلیل قطعی دیتاسنتر از دسترس خارج شوند، داشتن دیتای بکاپ روی باکت S3 کمکی به مسیریابی ترافیک نمیکند. برای استفاده از این دادهها، تیم زیرساخت باید سرورها، شبکههای مجازی و تنظیمات لودبالانسر را از نو Provision کند؛ فرآیندی که زمان بازیابی (Downtime) را بهشدت افزایش داده و برای سیستمهای Mission-Critical قابل قبول نیست.
Disaster Recovery چیست و چه کاربردی دارد؟
بازیابی فاجعه (Disaster Recovery)، یک استراتژی معماری برای بازگردانی کل سرویس IT پس از وقوع قطعیهای بحرانی در سطح دیتاسنتر یا زیرساخت شبکه است. برخلاف Backup که تمرکز آن صرفاً روی حفظ وضعیت «داده» است، هدف DR تضمین تداوم کسبوکار (Business Continuity) و احیای سریع زیرساخت پردازشی، قوانین مسیریابی، لودبالانسرها و دیتابیس در یک سایت ثانویه است.
این معماری معمولاً با اتکا به اتوماسیون، مفاهیم زیرساخت بهعنوان کد (IaC) و همگامسازی مداوم دادهها (Data Replication) طراحی میشود تا در زمان از دسترس خارج شدن کلاستر اصلی، زیرساخت جایگزین در کمترین زمان ممکن آماده پذیرش ترافیک (Failover) باشد.
محدودیتها و Trade-offها: نگهداری یک سایت DR آمادهبهکار (Standby)، هزینههای زیرساخت کلاود یا سختافزار فیزیکی را به شکل چشمگیری افزایش میدهد. علاوه بر این، پیادهسازی همگامسازی همزمان (Synchronous Replication) برای دیتابیسها میان دو سایت با فاصله جغرافیایی، میتواند باعث ایجاد تاخیر (Latency) در تراکنشها شود. بسته به نیازمندیهای سیستم و ابعاد پروژه، سطح پیادهسازی این الگو باید بر اساس میزان تحملپذیری سازمان در برابر قطعی (Downtime) و بودجه عملیاتی بالانس شود.
تفاوت Backup و Disaster Recovery چیست؟
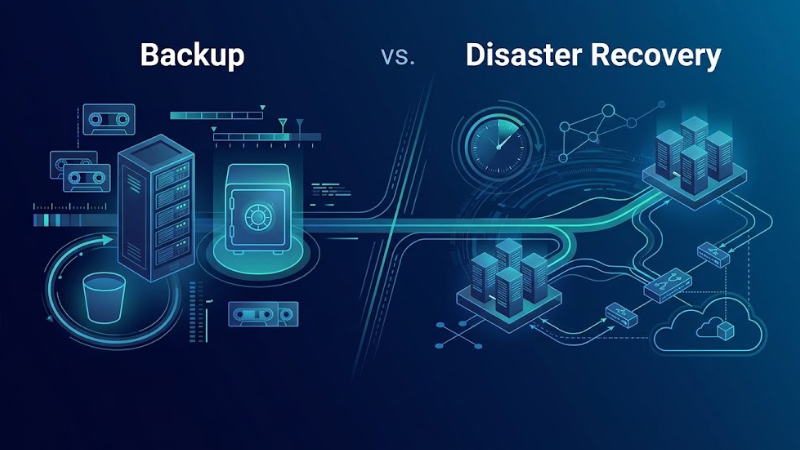
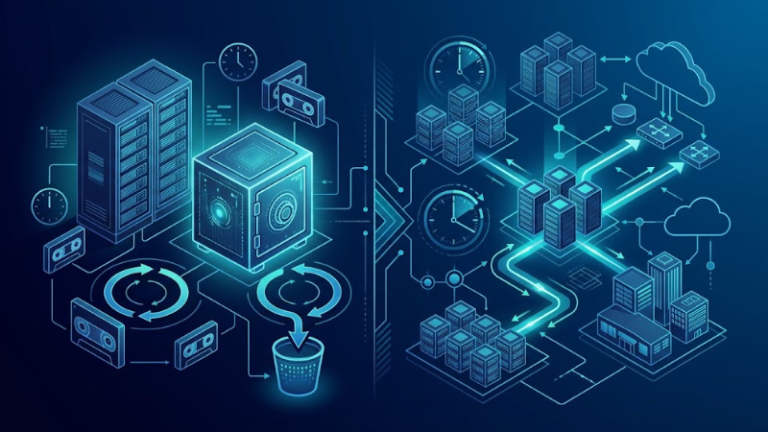
تفاوت Backup و Disaster Recovery در مقیاس عملیاتی، تفاوت میان «حفظ یک دارایی» و «بقا در شرایط بحرانی» است. پشتیبانگیری بر کپی کردن دادههای خام در بازههای زمانی مشخص متمرکز است تا از فقدان دیتا در اثر خطاهای انسانی یا باگهای نرمافزاری جلوگیری کند. در مقابل، استراتژی بازیابی فاجعه (Disaster Recovery) مجموعهای از فرآیندهای معماریشده است که علاوه بر دادهها، بازتولید کل State سرویس شامل شبکههای مجازی، سرورها و تنظیمات لودبالانسر را در یک محیط جایگزین تضمین میکند.
جدول زیر مرزهای عملیاتی این دو مفهوم را در معماری سیستم متمایز میکند:
| ویژگی معماری | پشتیبانگیری (Backup) | بازیابی فاجعه (Disaster Recovery) |
|---|---|---|
| هدف استراتژیک | حفظ و آرشیو دادههای تغییریافته | تداوم کسبوکار و احیای کل سرویس |
| دامنه بازیابی | فایلها، دیتابیسها و ولومها (Volumes) | زیرساخت پردازشی، شبکه، کانفیگ و دیتا |
| بستر ذخیرهسازی | فضاهای ارزان و پایدار (مانند Object Storage) | سایت ثانویه آمادهبهکار (Active/Passive) |
| زمان بازیابی (Downtime) | طولانی (نیازمند پروویژن مجدد زیرساخت) | بسیار کوتاه (سوئیچ ترافیک به سایت جایگزین) |
| هزینه عملیاتی | پایین (صرفاً هزینه مصرف فضای ذخیرهسازی) | بالا (هزینه نگهداری زیرساخت استندبای و پهنای باند) |
Backup و Disaster Recovery در ابر چگونه اجرا میشوند؟
محیطهای ابری با ارائه زیرساختهای منعطف و مبتنی بر API، پیادهسازی این دو مفهوم را از مدلهای سختافزاری سنتی به رویکردهای نرمافزارمحور ارتقا دادهاند.
در معماری کلاودنیتیو (Cloud-Native)، اجرای پشتیبان گیری ابری از طریق مکانیزمهایی نظیر اسنپشاتهای سطح بلاک (Block-level Snapshots) و سرویسهای ذخیرهسازی شیءگرا با قابلیت نسخهبندی (Versioning) مدیریت میشود. پلاگینهای CSI در محیطهای کانتینری نیز امکان تهیه نسخههای پشتیبان یکپارچه از استوریجهای متصل به پادها را فراهم میکنند.
در مقابل، اجرای DR در ابر بر پایه زیرساخت تغییرناپذیر (Immutable Infrastructure) و توزیع جغرافیایی منابع استوار است. مهندسان کلاود با ابزارهای IaC (نظیر Terraform) و طراحی چند-منطقهای (Multi-Zone)، سایتهای ثانویه را پیکربندی میکنند. بسته به معماری پروژه و نیاز به ایزولهسازی شبکه، استفاده از خدمات ابر خصوصی در سایت DR، کنترل بالاتری روی روتینگ ترافیک ایجاد کرده و تاخیر (Latency) همگامسازی دیتابیسها را کاهش میدهد.
RPO و RTO چه تفاوتی با هم دارند؟
طراحی استراتژی تابآوری بر دو شاخص کلیدی بنا میشود که مرز بین هزینههای زیرساخت و تحملپذیری کسبوکار را تعیین میکنند:
- شاخص RPO (Recovery Point Objective): نشاندهنده حداکثر دیتای ازدسترفتهی مجاز بر حسب زمان است. رساندن این عدد به صفر نیازمند همگامسازی همزمان (Synchronous Replication) است که بار پردازشی را بالا برده و مدیریت پهنای باند شبکه را چالشبرانگیز میکند.
- شاخص RTO (Recovery Time Objective): حداکثر زمان مجاز برای قطعی (Downtime) و بازگردانی کامل سرویس را مشخص میکند. کاهش این زمان مستلزم استقرار سایتهای آمادهبهکار (Standby) و اتوماسیون از طریق IaC است.
جدول زیر کاربرد و چالشهای عملیاتی این دو شاخص را در سطح معماری مقایسه میکند:
| شاخص کلیدی | نقطه تمرکز | روش بهینهسازی در زیرساخت | چالش و Trade-off عملیاتی |
|---|---|---|---|
| RPO | تحملپذیری در برابر فقدان دیتا | Replication مداوم و اسنپشاتهای مکرر | مصرف بالای پهنای باند شبکه و خطر Latency |
| RTO | تحملپذیری در برابر قطعی (Downtime) | معماری Active/Passive و اتوماسیون کامل IaC | افزایش قابلتوجه هزینههای نگهداری سایت جایگزین |
ابر خصوصی چه نقشی در Disaster Recovery دارد؟
پیادهسازی سایت ثانویه (DR Site) روی محیطهای اشتراکی، گاهی با چالشهایی نظیر افتوخیز پرفورمنس ناشی از پدیده همسایگی منابع (Noisy Neighbor) و محدودیت در پیادهسازی شبکههای لایه دو (L2) همراه است. در سیستمهای توزیعشده با حساسیت بالا، بهکارگیری زیرساختهای ایزوله، کنترل عمیقتری بر لایههای زیرین شبکه و استوریج فراهم میکند.
ورود پلتفرمهای ابر خصوصی (Private Cloud) به استراتژی DR، مزیتهای مهندسی مشخصی برای سازمانهای Enterprise به همراه دارد:
- ایزولهسازی شبکه و تضمین پهنای باند: تخصیص منابع اختصاصی و لینکهای مستقیم میان دیتاسنتر اصلی و سایت DR، چالش Latency در فرآیند همگامسازی دیتابیسهای کلاسترشده را به شدت کاهش میدهد.
- کنترل مستقیم بر Hypervisor و استوریج: در معماری ابر خصوصی، امکان تنظیم دقیق IOPS دیسکها و سیاستهای زمانبندی (Scheduling) نودها متناسب با بار کاری بحرانی و الگوهای ترافیکی سازمان وجود دارد.
- انطباقپذیری امنیتی (Compliance): نگهداری دادههای حساس و کلیدهای رمزنگاری در یک محیط ایزوله و اختصاصی، ریسکهای امنیتی در زمان مهاجرت بار کاری (Workload Migration) به سایت جایگزین را دفع میکند.
بسته به سطح نیازمندیهای توافقنامه سطح سرویس (SLA) و بودجه سازمان، پیادهسازی استراتژی DR بر بستر ابر خصوصی میتواند تعادل پایداری میان امنیت سختگیرانه، کنترل معماری و تضمین آپتایم ایجاد کند.
جمعبندی
اتکای صرف به آرشیو دادهها برای تضمین پایداری سیستمهای حیاتی، یک خطای استراتژیک در معماری زیرساخت است. درک دقیق تفاوت Backup و Disaster Recovery به تیمهای مهندسی نشان میدهد که حفظ دیتا تنها پیشنیاز تابآوری است؛ چالش اصلی، توانایی احیای سریع لایههای شبکه و سرورها برای بازگشت فوری به مدار سرویسدهی است. پیادهسازی یک مکانیزم Failover بدون نقص، نیازمند اتوماسیون، زیرساخت ایزوله و ارزیابی مداوم است. برای تحلیل ظرفیتهای سازمان و طراحی زیرساختی مقاوم در برابر بحران، میتوانید درخواست ممیزی (Audit) و مشاوره معماری خود را با متخصصان دواپس ایران مطرح کنید.
سوالات متداول
آیا افزونگی بالا (High Availability) میتواند جایگزین معماری DR شود؟
خیر؛ HA برای دفع خطاهای سطح نود و کانتینر طراحی شده است، درحالیکه DR وظیفه احیای کل زیرساخت و شبکه را در زمان قطعیهای گسترده دیتاسنتر بر عهده دارد.
مانورهای بازیابی بحران (DR Drill) در چه فواصل زمانی باید اجرا شوند؟
بسته به سطح SLA پروژه، این مانورها عموماً بهصورت فصلی یا ششماهه در محیطهای کنترلشده اجرا میشوند تا صحت عملکرد ابزارهای IaC و زمانبندی شاخصهای بازیابی ارزیابی گردد.
چرا در استراتژیهای مدرن پشتیبانگیری بر قابلیت Immutable Backup تاکید میشود؟
این مکانیزم با قفل کردن دادهها در سطح استوریج، مانع از تغییر یا حذف فایلها شده و مطمئنترین لایه دفاعی را برای بازگردانی سیستم پس از حملات باجافزاری فراهم میکند.
نشانی ایمیل شما منتشر نخواهد شد. بخشهای موردنیاز علامتگذاری شدهاند *
نظر دهید تعداد کاراکتر مانده: 300