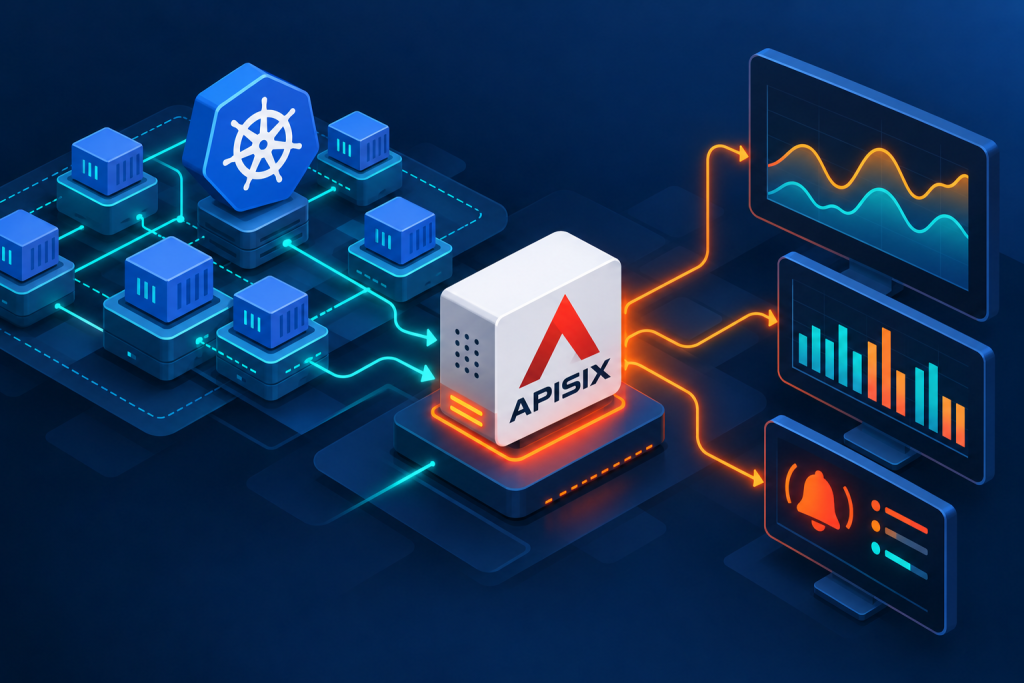
اگر با نقش این ابزار در ورودی کلاستر آشنا نیستید، ابتدا مقاله APISIX روی Kubernetes را بخوانید. در این مقاله، مسیر طراحی پایش را از جمعآوری متریک تا تنظیم هشدار و بررسی رخداد مرور میکنیم.
چه بخشهایی از APISIX را باید پایش کنیم؟
پایش را در سه لایه ببینید: نتیجه درخواست از دید کاربر، سلامت اجزای Gateway و وضعیت تحویل پیکربندی. سالمبودن Pod بهتنهایی نشان نمیدهد که یک مسیر درست کار میکند. همچنین پاسخدادن مسیرهای موجود ثابت نمیکند تغییر جدید بهدرستی اعمال شده است.
برای یک API مهم، هدف قابل اندازهگیری تعریف کنید؛ مثلاً نرخ موفقیت و زمان پاسخ قابل قبول. سپس مشخص کنید داده لازم از کدام بخش جمعآوری میشود و مسئول رسیدگی به افت کیفیت چه کسی است. آستانهها باید با نیاز همان سرویس و الگوی ترافیک واقعی هماهنگ باشند.
جمعآوری متریک با Prometheus
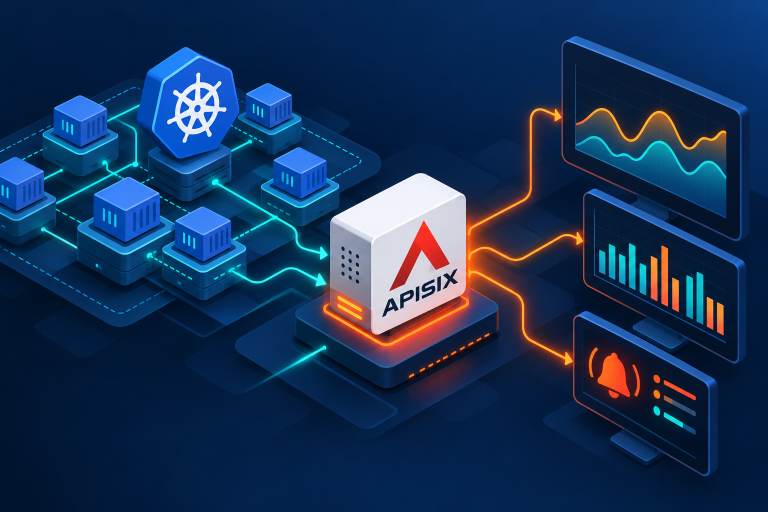
افزونه Prometheus در APISIX متریکهایی مانند کد پاسخ HTTP و زمان پاسخ را ارائه میکند. در مستندات، متریکهای apisix_http_status و apisix_http_latency و برچسبهایی برای تفکیک مسیر و سرویس توضیح داده شدهاند. نام، برچسبها و فعالبودن متریکها را با نسخه نصبشده تطبیق دهید.
در Kubernetes، مسیر دسترسی Prometheus به هر نمونه APISIX را طراحی کنید. فعالبودن endpoint خروجی، بهتنهایی به معنی جمعآوری موفق نیست؛ دسترسی شبکه و کشف هدفها نیز باید بررسی شوند. endpoint متریک و رابط مدیریتی را با ورودی عمومی کاربران یکی فرض نکنید.
برای تنظیمات و محدودیتها، مستندات رسمی افزونه Prometheus در APISIX را مبنا قرار دهید. ابتدا با ارسال درخواست آزمایشی، تولید متریک و رسیدن آن به سامانه پایش را تأیید کنید.
داشبورد Grafana چه پرسشهایی را پاسخ دهد؟
داشبورد را بر اساس تصمیمهای تیم بسازید. نمای اول باید نشان دهد آیا کاربران با اختلال روبهرو هستند؛ نماهای بعدی باید امکان محدودکردن بررسی به مسیر، سرویس و نمونه Gateway را بدهند.
- حجم ترافیک: آیا تعداد درخواستها با الگوی معمول همخوان است؟ کاهش ناگهانی ترافیک هم میتواند مسئله باشد.
- نرخ خطا: خطاها در کدام مسیر بیشتر شدهاند و چه سهمی از درخواستها را تشکیل میدهند؟
- تأخیر: علاوه بر میانگین، صدکهایی مانند p95 را برای مشاهده درخواستهای کند بررسی کنید؛ محاسبه باید با نوع متریک و واحد آن سازگار باشد.
- سلامت اجرا: مصرف منابع، Restartها و وضعیت نمونههای Gateway را کنار کیفیت درخواستها ببینید.
- سلامت پایش: آیا داده تازه است و تمام نمونههای مورد انتظار جمعآوری میشوند؟
نمودار تجمیعی ممکن است مشکل یک مسیر کمترافیک اما حیاتی را پنهان کند. برای APIهای مهم، نمای جداگانه داشته باشید. در مقابل، برچسبهای بسیار متنوع میتوانند تعداد سریهای زمانی را افزایش دهند؛ ابعاد پایش را متناسب با نیاز واقعی انتخاب کنید.
تفسیر خطاها؛ فقط عدد 5xx را نبینید
افزایش خطای 5xx یک نشانه است، نه علت نهایی. زمان شروع، مسیرهای درگیر و تغییرات اخیر را بررسی کنید و نتیجه را با لاگها و وضعیت Backend مقایسه کنید. خطاهای احراز هویت یا پاسخهای محدودیت نرخ نیز باید جدا از خطای داخلی سرویس تفسیر شوند.
نرخ خطا را همراه با حجم درخواست ببینید. درصد بالا در چند درخواست محدود، با همان درصد در یک سرویس پرترافیک اثر یکسانی ندارد. از سوی دیگر، افت کامل ترافیک ممکن است نمودار خطا را ظاهراً آرام نشان دهد؛ آزمون بیرونی مسیر کاربر میتواند این نقطه کور را پوشش دهد.
لاگها چگونه به عیبیابی کمک میکنند؟
متریکها روند را نشان میدهند؛ لاگها برای بررسی درخواست مشخص کاربرد دارند. APISIX افزونههایی برای ارسال لاگ دارد؛ برای نمونه، http-logger ارسال اطلاعات به مقصد HTTP و تنظیم قالب لاگ را مستند کرده است. رفتار ارسال گروهی، صف و خطاهای مقصد باید در طراحی لحاظ شود. راهنمای رسمی http-logger.
در طراحی لاگ، اطلاعات لازم برای همبستگی درخواستها را مشخص کنید. ثبت Token، Cookie یا محتوای حساس درخواست را به پیشفرض عیبیابی تبدیل نکنید. مدت نگهداری، سطح دسترسی و روش حذف داده نیز باید روشن باشد.
هشدارهای قابل اقدام طراحی کنید
هر هشدار باید مالک، شرح اثر، مدت تداوم و راهنمای بررسی داشته باشد. برای شروع، افت پایدار کیفیت APIهای مهم، دسترسنبودن هدف جمعآوری متریک و افزایش غیرعادی Restartها را بررسی کنید. مقدار و مدت آستانه را با داده واقعی بسنجید؛ نسخه یکسان برای همه سرویسها مناسب نیست.
پس از رخداد، بررسی کنید هشدار بهموقع رسیده و اطلاعات کافی داشته است یا نه. هشدارهای تکراری را گروهبندی کنید و برای تغییرات برنامهریزیشده، فرایند مشخص داشته باشید تا هشدار مهم در میان اعلانهای کماثر گم نشود.
یک سناریوی عملی برای بررسی کندی API
فرض کنید پس از انتشار نسخه جدید برنامه، زمان پاسخ یک مسیر افزایش یافته است. ابتدا گستره اثر و حجم ترافیک را بررسی کنید. سپس تأخیر Backend، منابع Gateway و لاگ درخواستهای نمونه را کنار زمان انتشار قرار دهید. همزمانی نمودارها اثبات علت نیست؛ نتیجه باید با شواهد یا آزمون کنترلشده تأیید شود.
اگر تغییر پیکربندی Gateway مطرح است، وضعیت کنترلر و اعمال تنظیمات را نیز بررسی کنید. بازگرداندن نسخه قبلی باید مطابق برنامه تغییر و با سنجش اثر انجام شود. هدف، بازگشت کیفیت سرویس و ثبت علت قابل اتکاست.
از داشبورد تا بهرهبرداری پایدار
مانیتورینگ APISIX زمانی ارزش عملیاتی دارد که داده قابل اعتماد، هشدار مناسب و راهنمای رسیدگی در کنار هم باشند. برای بررسی طراحی پایش و پشتیبانی زیرساخت سازمان، صفحه خدمات تخصصی دواپس ایران را ببینید.
نشانی ایمیل شما منتشر نخواهد شد. بخشهای موردنیاز علامتگذاری شدهاند *
نظر دهید تعداد کاراکتر مانده: 300