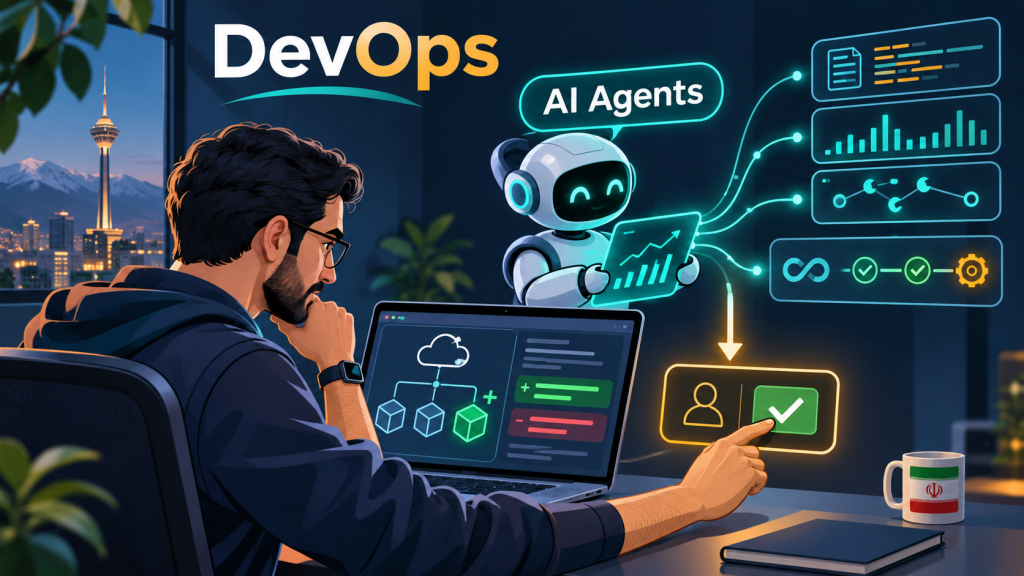
وقتی یک مرحله از CI/CD شکست میخورد یا نرخ خطا پس از انتشار بالا میرود، بخشی از وقت تیم دواپس صرف پیدا کردن شواهد در چند ابزار مختلف میشود. یک AI Agent یا عامل هوش مصنوعی میتواند این شواهد را جمعآوری کند، نتیجه را خلاصه کند و قدم بعدی را برای بررسی پیشنهاد دهد.
AI Agent چیست و چه تفاوتی با اسکریپت دارد؟
عامل هوش مصنوعی برای رسیدن به یک هدف از مدل زبانی و مجموعهای از ابزارهای مجاز استفاده میکند. برای نمونه، نتیجهٔ خواندن یک لاگ میتواند تعیین کند که در قدم بعدی سراغ تاریخچهٔ استقرار برود یا وضعیت یک سرویس را بررسی کند. اسکریپت معمولاً مراحلی را اجرا میکند که از قبل تعریف شدهاند. یک چتبات ساده نیز عمدتاً از اطلاعات موجود در گفتوگو پاسخ میدهد. تفاوت عامل در توانایی استفاده از ابزار و انتخاب قدم بعدی بر اساس نتیجهٔ قبلی است. راهنمای طراحی عاملهای هوش مصنوعی
کاربرد AI Agent در تیمهای دواپس
- تحلیل خطای CI/CD. عامل میتواند مرحلهٔ شکستخورده را پیدا کند، پیام خطای اصلی را جدا کند و آن را کنار تغییرات اخیر بگذارد. خروجی مفید شامل لینک اجرای Pipeline و شواهدی است که توسعهدهنده بتواند بررسی کند.
- بررسی اولیهٔ رخدادها. عامل میتواند هشدارها، متریکها، لاگها و زمان انتشار را کنار هم قرار دهد و مشاهدات را از فرضیهها جدا کند.
- بهروزرسانی مستندات عملیاتی. پس از رفع رخداد، عامل میتواند پیشنویس Runbook را با مراحل تشخیص و اقدام اصلاحی تکمیل کند تا مالک سرویس آن را بازبینی کند.
- پیشنهاد تغییر زیرساخت. عامل میتواند تغییر یک فایل Kubernetes یا تنظیم Pipeline را در قالب Pull Request آماده کند تا تیم اختلاف فایلها و نتایج آزمون را بررسی کند.
مثال عملی از بررسی خطا پس از انتشار
فرض کنید چند دقیقه بعد از انتشار نسخهٔ جدید، نرخ پاسخهای HTTP 5xx افزایش پیدا میکند. عامل ابتدا زمان هشدار را با زمان استقرار تطبیق میدهد. سپس متریک و لاگ نسخهٔ جدید را با نسخهٔ قبلی مقایسه میکند. اگر نمونههای خطا نشان دهند درخواستهای یک مسیر مشخص به زمان انتظار اتصال رسیدهاند، عامل میتواند مسیر آسیبدیده و بازهٔ زمانی را گزارش کند و بررسی وابستگی یا تغییر تنظیمات را پیشنهاد دهد. همزمانی دو رخداد به تنهایی علت را ثابت نمیکند. مسئول رخداد شواهد را بررسی میکند و دربارهٔ ادامهٔ عیبیابی یا بازگشت نسخه تصمیم میگیرد.
محدودیتها و کنترلهای لازم
عامل ممکن است از دادههای ناقص نتیجهگیری کند یا پیشنهادش با سیاست تیم سازگار نباشد. لاگها، تیکتها و متن Pull Request ممکن است حاوی دستورهایی باشند که از منابع نامطمئن آمدهاند. این محتوا باید به عنوان داده بررسی شود. دسترسی فقطخواندنی، ابزارهای محدود، حذف دادههای حساس از ورودی و ثبت اقدامات، محدودهٔ اثر خطا را کاهش میدهند. تغییر محیط عملیاتی باید از مسیر تأیید تیم و با برنامهٔ بازگشت انجام شود. راهنمای استفادهٔ مسئولانه از عاملها در GitHub
از کجا شروع کنیم؟
یک کار پرتکرار و مشخص، مثل خلاصهکردن اجرای ناموفق Pipeline یک مخزن را انتخاب کنید. به عامل دسترسی فقطخواندنی بدهید و خروجی را با بررسی مهندس مقایسه کنید. زمان رسیدن به تشخیص اولیه، درصد گزارشهای دارای شواهد معتبر و میزان اصلاح لازم را بسنجید. اگر تیم با خروجی سریعتر به شواهد درست میرسد، میتوانید دامنه را به کار مشابه دیگری گسترش دهید.
تعریف دسترسی، بازبینی تغییرات و مسئولیت رخداد همچنان بر عهدهٔ تیم است. برای طراحی فرایندهای CI/CD و بهبود مشاهدهپذیری میتوانید با خدمات دواپس ایران آشنا شوید.
مشاهده خدمات دواپس ایرانطراحی و بهبود فرایندهای تحویل نرمافزار، مانیتورینگ و مدیریت زیرساخت
نشانی ایمیل شما منتشر نخواهد شد. بخشهای موردنیاز علامتگذاری شدهاند *
نظر دهید تعداد کاراکتر مانده: 300