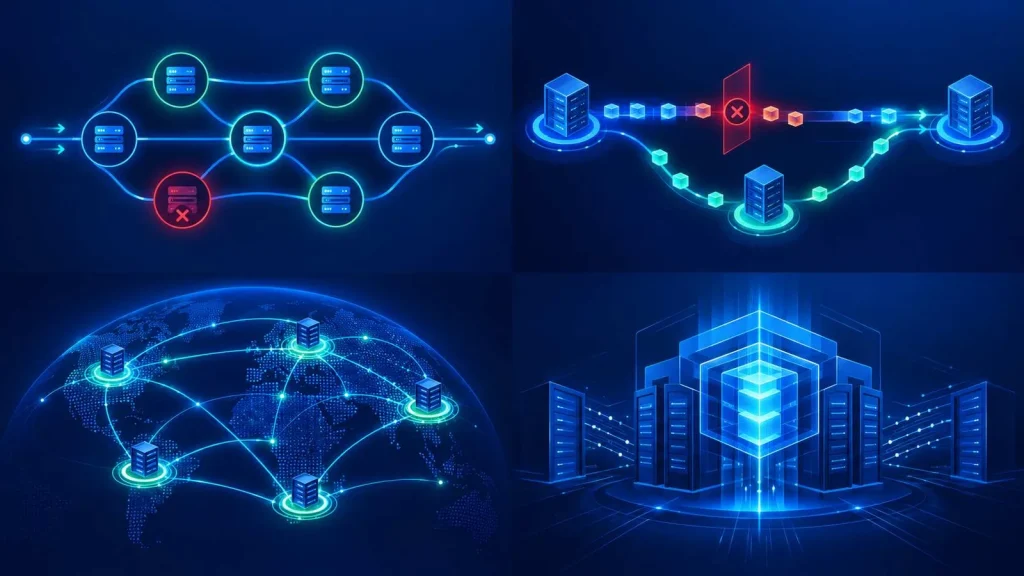
قطعی ناگهانی یکی از نودهای پروداکشن زیر بار ترافیک سنگین و متوقف شدن کانتینرهای کوبرنتیز (Kubernetes)، سناریویی است که هیچ تیم زیرساختی تمایلی به تجربه آن ندارد. این اتفاق بلافاصله منجر به نقض توافقنامه سطح خدمات (SLA) و از دست رفتن درخواستهای کاربران میشود. در چنین شرایطی، درک اینکه High Availability چیست و چگونه پیادهسازی میشود، مرز میان یک زیرساخت آسیبپذیر و یک سیستم پایدار سازمانی را مشخص میکند. این مفهوم که در ادبیات مهندسی سیستمها به اختصار HA نامیده میشود، پاسخی ساختاریافته برای حذف نقاط تکشکست و تضمین پایداری است. در این مقاله با تکیه بر تجربه عملی تیم دواپس ایران در ارزیابی زیرساختهای بزرگ، به کالبدشکافی مکانیسمهای پایداری، مکانیزمهای بازگشت خودکار به حالت پایدار (Failover)، تفاوتهای آن با بازیابی فاجعه (Disaster Recovery) و الگوهای پیادهسازی این معماری در زیرساختهای ابری و ابر خصوصی میپردازیم تا پایداری سیستمها از سطح تئوری به قابلیت اطمینان عملیاتی ارتقا پیدا کند.
High Availability چیست و چگونه کار میکند؟
در مهندسی سیستمهای مقیاسپذیر، دسترسپذیری بالا به مجموعهای از الگوهای معماری و سختافزاری/نرمافزاری گفته میشود که تضمین میکنند یک سیستم یا سرویس بدون وقفه طولانی به کار خود ادامه دهد. این مفهوم معمولاً با شاخص «نهِ ۹» (Number of Nines) اندازهگیری میشود؛ برای مثال، استاندارد پایداری ۹۹.۹۹۹٪ (یا پنج نه) به این معناست که کل زمان قطعی مجاز سیستم در طول سال کمتر از ۵ دقیقه و ۲۶ ثانیه خواهد بود.
هسته مرکزی HA بر پایه حذف «نقطه تکشکست» (Single Point of Failure یا به اختصار SPOF) بنا شده است. اگر در یک سیستم تمام درخواستها به یک سرور، دیتابیس یا سوئیچ شبکه واحد وابسته باشند، با کوچکترین اختلال در آن جزء، کل سرویس از دسترس خارج میشود. در یک معماری مقاوم، هیچ جزء حیاتی منفردی وجود ندارد و بار پردازشی میان چندین لایه موازی توزیع میشود. البته این رویکرد به معنای حذف کامل قطعی نیست، بلکه سیستم به گونهای طراحی میشود که خرابی یک زیرساخت یا نود، بدون دخالت دستی و در کسری از ثانیه مدیریت شود.
معماری High Availability از چه اجزایی تشکیل میشود؟
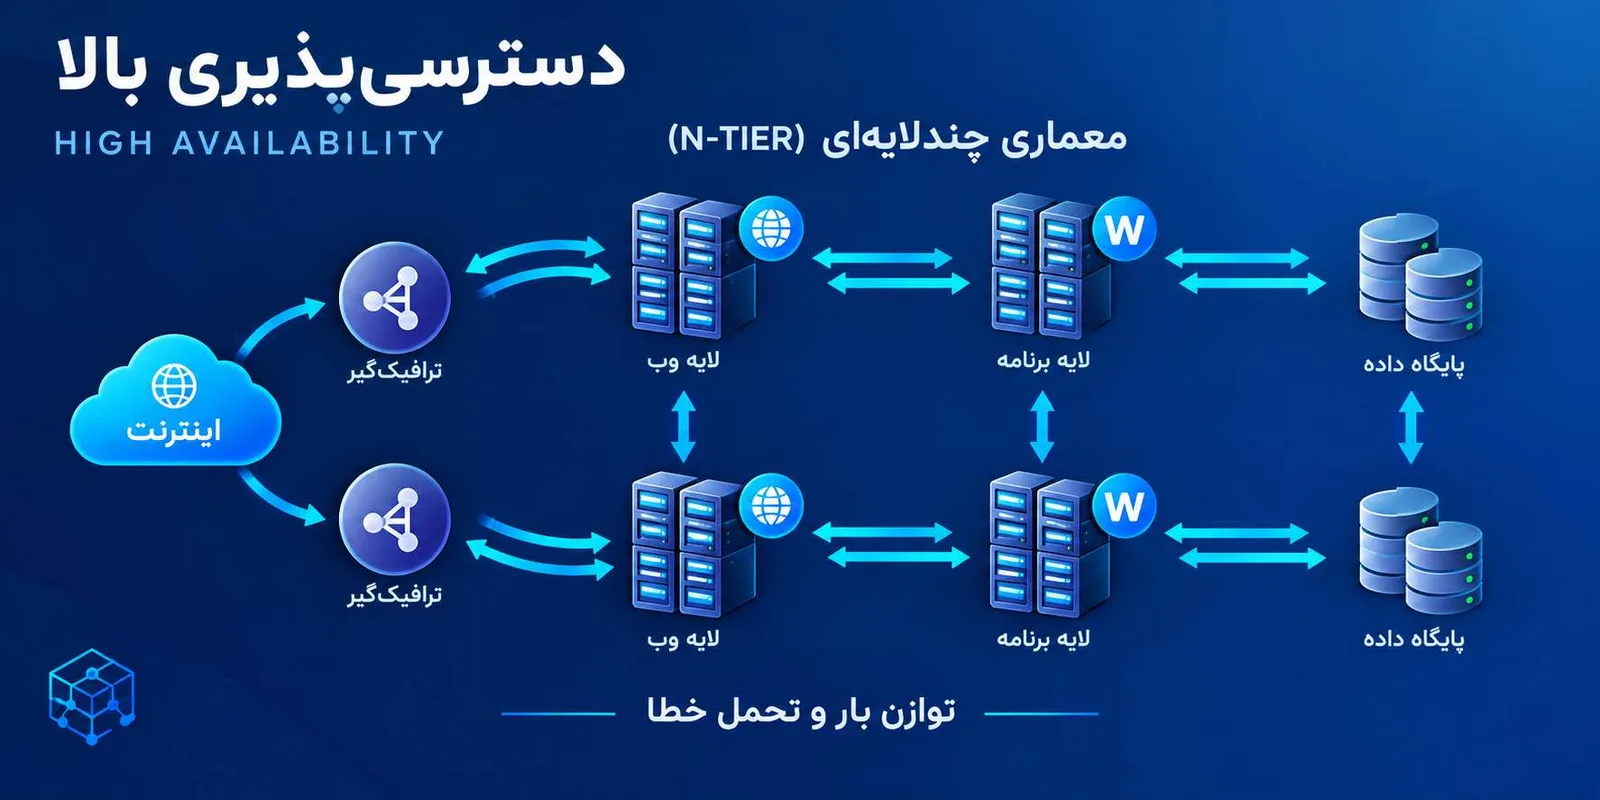
پیادهسازی یک زیرساخت با دسترسپذیری بالا نیازمند هماهنگی دقیق میان چند لایه کلیدی است. بدون حضور این اجزا، دستیابی به پایداری پایدار در محیطهای پربازدید غیرممکن خواهد بود:
- توزیعکننده بار (Load Balancer): لایه ورودی ترافیک که درخواستها را میان سرورهای بکاند مختلف تقسیم میکند و سلامت نودها را به صورت لحظهای مانیتور میکند.
- گرههای افزونبر (Redundant Nodes): وجود حداقل دو یا چند نمونه موازی از سرویسها (مثل پادهای کوبرنتیز یا ماشینهای مجازی) که میتوانند بار کاری یکدیگر را پوشش دهند.
- لایه داده یکپارچه (Shared or Replicated Storage/Database): دیتابیسها و سیستمهای فایلی که مکانیزمهای همگامسازی (Replication) دقیق دارند تا دادهها در تمام نودها بهروز بمانند.
- سیستم بررسی سلامت (Health Checks & Heartbeat): مکانیزمهای سیگنالدهی مداوم که قطع ارتباط یک نود را در چند میلیثانیه شناسایی میکنند.
بسته به نوع زیرساخت و بودجه عملیاتی سازمان، پیکربندی این اجزا میتواند به سمت الگوهای توزیعشده یا ابری میل کند.
بیشتر بخوانید: معماری رایانش ابری چیست
افزونگی و Failover چه نقشی در High Availability دارند؟
پایهگذار اصلی پایداری در معماریهای صنعتی، ترکیب همزمان دو مفهوم «افزونگی» (Redundancy) و «فیلاور» (Failover) است. افزونگی به معنای تکثیر منابع (سرور، دیتابیس، شبکه) است؛ اما داشتن تجهیزات اضافه تا زمانی که سیستم نتواند به صورت خودکار کنترلی روی آنها اعمال کند، کمتی به پایداری نمیکند.
هنگامی که یک نود اصلی دچار اختلال میشود، فرآیند Failover وارد عمل میشود تا ترافیک را به مسیر جایگزین هدایت کند. این انتقال میتواند به دو شکل پیادهسازی شود:
- پیکربندی فعال-فعال (Active-Active): تمام نودها همزمان زیر بار هستند و درخواستها را پردازش میکنند.
- پیکربندی فعال-پشتیبان (Active-Passive): نود دوم در حالت آمادهباش (Standby) است و صرفاً پس از قطع شدن نود اول، فعال میشود.
سناریوی واقعی در پروداکشن: در یکی از سامانههای مالی، دیتابیس اصلی PostgreSQL به دلیل نشت حافظه (Memory Leak) و رسیدن به خطای OOMKilled دچار توقف شد. در این زیرساخت که به صورت Active-Passive پیکربندی شده بود، سیستم مانیتورینگ افت سیگنال قلب (Heartbeat) را در کمتر از ۳ ثانیه ثبت کرد. موتور ارکستراسیون بهصورت خودکار نقش Primary را به نود Replica منتقل نمود. با وجود تغییر نقش، به دلیل تاخیر جزئی در همگامسازی ناهمگام (Asynchronous Replication)، چند تراکنش در صف انتظار دچار وقفه میلیثانیهای شدند. پس از این رخداد، تیم مهندسی با بازنگری در پارامترهای تکرار داده و سوییچ به حالت همگام (Synchronous)، زمان بازگشت سرویس (Recovery Time) را به صفر نزدیکتر کرد.
High Availability چه تفاوتی با Disaster Recovery دارد؟
در طراحی معماری سیستمهای سازمانی، اشتباه گرفتن این دو مفهوم میتواند هزینههای سنگینی به همراه داشته باشد.
- High Availability تمرکز خود را بر روی تداوم کسبوکار در برابر خرابیهای جزئی و معمول (مانند قطعی سختافزار، خرابی دیسک، خطای نرمافزاری یا اختلال شبکه محلی) معطوف میکند. هدف در اینجا به حداقل رساندن Downtime و حفظ پایداری لحظهای سرویس است.
- بازیابی فاجعه (Disaster Recovery یا DR) به سناریوهای بحرانی و مقیاس بزرگ (مانند آتشسوزی در دیتاسنتر، زلزله، قطع سراسری برق منطقه یا حملات سایبری گسترده به کل زیرساخت) مربوط میشود. در DR، تمرکز روی شاخصهای کلیدی زمان بازگشت (RTO) و نقطه بازگشت داده (RPO) در مقیاسهای جغرافیایی متفاوت است.
به بیان ساده، HA مانع از زمین خوردن سیستم در برابر رویدادهای روزمره میشود، در حالی که DR چتر نجات سازمان در برابر فجایع ساختاری بزرگ است.
High Availability چگونه در زیرساخت ابری پیادهسازی میشود؟
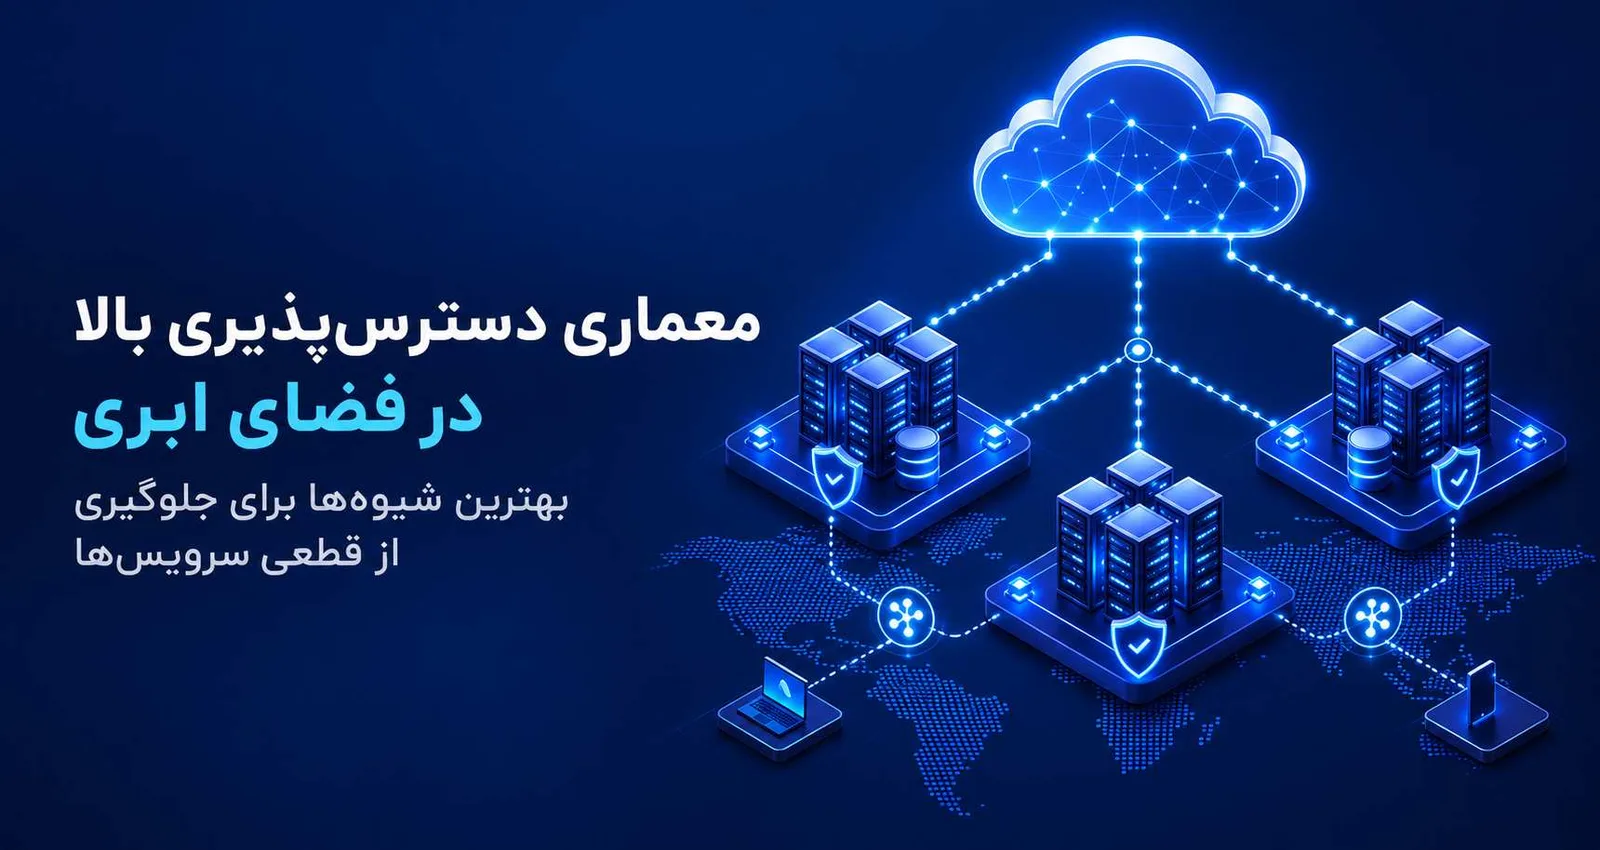
معماریهای ابری مدرن ابزارهای قدرتمندی برای پیادهسازی پایداری در اختیار مهندسان قرار میدهند. استفاده از مناطق در دسترسپذیری چندگانه (Multi-AZ) پایهترین روش ایجاد HA در ابر است. در این الگو، منابع پردازشی و دیتابیسها در چندین دیتاسنتر فیزیکی مجزا اما متصل به یکدیگر در یک ریجن (Region) توزیع میشوند. اگر یک دیتاسنتر ابری دچار اختلال برق یا شبکه شود، ترافیک به صورت خودکار توسط لودبالانسرهای ابری به دیتاسنتر دیگر هدایت میشود. افزون بر این، استفاده از کلاسترهای مدیریتی کوبرنتیز با گرههای توزیعشده در این مناطق، پایداری کانتینرها را در سطح بالایی تضمین میکند.
High Availability چه نقشی در معماری ابر خصوصی دارد؟
در پیادهسازی زیرساختهای ابر خصوصی روی سختافزارهای اختصاصی (Bare-Metal)، تمام مسئولیت پایداری سیستم برخلاف سرویسهای ابری عمومی بر عهده تیم مهندسی داخلی است. در این معماری، استفاده از ابر خصوصی به همراه مکانیزمهای HA برای حذف نقاط تکشکست (SPOF) در لایههای مجازیسازی، ذخیرهسازی توزیعشده و شبکههای تعریفشده با نرمافزار (SDN) حیاتی است.
با ایجاد افزونگی در سطح سرورهای فیزیکی و کلاسترهای هایپروایزور، حتی با خاموشی کامل یک سرور، سرویسهای کلیدی بدون قطعی به کار خود ادامه میدهند؛ دستیابی به این پایداری مستلزم طراحی دقیق توپولوژی شبکه و اتومیشن زیرساخت است.
طراحی و پیادهسازی اصولی معماری دسترسپذیری بالا نیازمند شناخت دقیق الگوهای ترافیکی، زیرساخت فیزیکی و نیازهای بیزینس است. برای ارزیابی شکافهای زیرساختی و ارتقای پایداری سیستمهای خود به استانداردهای سازمانی، میتوانید روی تجربه عملی تیم «دواپس ایران» حساب کنید. جهت بررسی وضعیت موجود و دریافت خدمات مشاوره تخصصی، آدیت زیرساخت و خدمات ابر خصوصی، درخواست مشاوره فنی خود را ثبت کنید.
جمعبندی
دسترسپذیری بالا (High Availability) برآیند تصمیمگیری هوشمندانه در لایه معماری سیستم است. همانطور که بررسی شد، حذف نقاط تکشکست، مدیریت لایههای افزونبر و تنظیم دقیق مکانیزمهای بازگشت خودکار، اصلیترین الزامات برای حفظ تداوم کسبوکار در برابر اختلالات اجتنابناپذیر پروداکشن هستند. در نهایت، انتخاب الگوی پیادهسازی HA چه در بستر ابری و چه در زیرساختهای ابر خصوصی، یک موازنه مهندسی میان هزینه، پیچیدگی عملیاتی و میزان ریسکپذیری سازمان شماست.
طراحی و پیادهسازی اصولی این معماری نیازمند ارزیابی دقیق الگوهای ترافیکی و زیرساخت موجود است. تیم «دواپس ایران» با تکیه بر تجربه عملی در ارتقای پایداری سامانههای بزرگ، آماده ارائه خدمات مشاوره تخصصی، آدیت زیرساخت ابر خصوصی متناسب با نیاز بیزینس شماست. برای بررسی وضعیت فعلی سیستم خود میتوانید درخواست مشاوره فنی را ثبت کنید.
سوالات متداول
۱. آیا پیادهسازی High Availability به معنای دو برابر شدن هزینههای زیرساخت است؟
خیر؛ اگرچه افزونگی نیازمند منابع سختافزاری یا ابری اضافی است، اما طراحی هوشمندانه معماری (مثل استفاده از الگوهای Active-Passive یا مقیاسپذیری خودکار بر اساس بار واقعی) میتواند هزینهها را به شکلی بهینه مدیریت کند که خسارات ناشی از قطعی سرویس به مراتب بیشتر از هزینههای زیرساخت افزونبر باشد.
۲. تفاوت اصلی بین Failover خودکار و دستی چیست؟
در فیلاور خودکار، سیستمهای مانیتورینگ و ارکستراسیون بدون نیاز به دخالت اپراتور انسانی، خرابی را تشخیص داده و ترافیک را جابهجا میکنند که زمان قطعی (Downtime) را به حداقل میرساند. فیلاور دستی نیازمند بررسی انسانی و دستورالعملهای اپراتوری است که زمان بازگشت سرویس را به شدت افزایش میدهد.
۳. چگونه میتوانیم از کارکرد صحیح مکانیزم HA در پروداکشن مطمئن شویم؟
تنها راه اطمینان، انجام تستهای منظم شکست (Chaos Engineering) و شبیهسازی قطعی نودها، دیتابیسها و شبکهها در محیطهای استیجینگ یا پروداکشن (تحت شرایط کنترلشده) است تا رفتار سیستم در برابر خطاهای واقعی سنجیده شود.
نشانی ایمیل شما منتشر نخواهد شد. بخشهای موردنیاز علامتگذاری شدهاند *
نظر دهید تعداد کاراکتر مانده: 300