کلاسترینگ سرور روشی برای اجرای یک سرویس یا پردازش در مجموعهای از سرورهای هماهنگ است تا خرابی یک نود، لزوماً به توقف کل سرویس منجر نشود. این ساختار بسته به معماری انتخابشده میتواند دسترسپذیری را افزایش دهد، درخواستها را میان چند سرور تقسیم کند یا توان پردازشی بیشتری در اختیار برنامه قرار دهد. بااینحال، کنار هم قرار دادن چند سرور بهخودیخود پایداری ایجاد نمیکند. کیفیت شبکه، نحوه نگهداری دادهها و سازوکار تشخیص خطا، نتیجه واقعی را مشخص میکنند. شناخت انواع خوشه، الگوهای اجرای سرویس و معیارهای آزمون، نقطه آغاز طراحی زیرساخت قابل اتکاست.
مفهوم و نحوه کار کلاسترینگ سرور
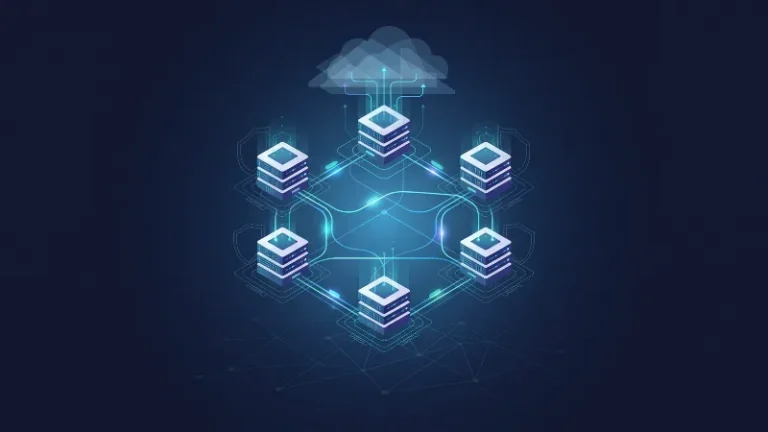
در پاسخ به پرسش «کلاسترینگ سرور چیست» باید میان یک گروه از سرورهای متصل و یک خوشه عملیاتی تفاوت گذاشت. در کلاستر، هر سرور یک نود (Node) است و نرمافزار مدیریت خوشه درباره سلامت اعضا، محل اجرای سرویس و واکنش به خرابی تصمیم میگیرد. از دید کاربر، چند نود میتوانند یک سرویس مشترک ارائه دهند، هرچند پیادهسازی آنها در لایه زیرساخت متفاوت باشد.
در یک کلاستر سرور با هدف تداوم خدمت، نودها از طریق پیامهای دورهای یا سازوکارهای نظارت بر سلامت، وضعیت یکدیگر را بررسی میکنند. اگر نود فعال از دسترس خارج شود، مدیر خوشه پس از اطمینان از شرایط مجاز، سرویس را روی عضو سالم دیگری راهاندازی میکند. این فرایند Failover نام دارد. بسته به نوع برنامه، جابهجایی ممکن است مستلزم بازیابی نشستها، اتصال دوباره کاربران یا بررسی یکپارچگی داده باشد.
پرسش «high availability چیست» به همین موضوع مربوط است. دسترسپذیری بالا به معماری و فرایندهایی اشاره دارد که مدت و دامنه اختلال را کاهش میدهند. این مفهوم وعده حذف همه قطعیها نیست. اگر تمام نودها به یک منبع تغذیه یا فضای ذخیرهسازی آسیبپذیر وابسته باشند، خرابی همان بخش میتواند کل سرویس را مختل کند.
دستهبندی خوشهها بر اساس هدف عملیاتی
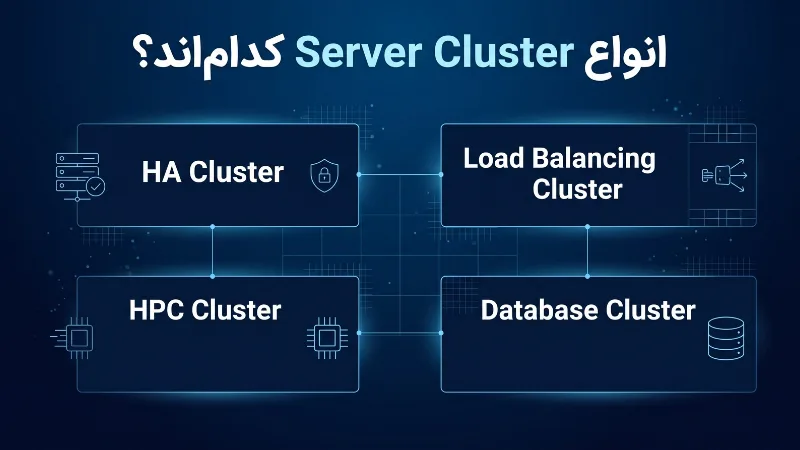
انواع Server Cluster را باید بر اساس مسئلهای انتخاب کرد که قرار است حل کنند. خوشه مناسب برای پردازش علمی، الزاماً گزینه درستی برای سامانه بانکی یا وبسایت پرترافیک نیست. تفاوت اصلی در نحوه توزیع کار، مدیریت وضعیت داده و واکنش به خرابی مشخص میشود.
| نوع خوشه | هدف اصلی | کاربرد شاخص |
| High Availability | ادامه خدمت پس از خرابی عضو | سامانههای سازمانی حساس |
| Load Balancing | توزیع درخواست بین نودهای سالم | وبسایت و API پرترافیک |
| High Performance Computing | اجرای موازی محاسبات | شبیهسازی و تحلیل عددی |
| Database Cluster | افزایش دسترسپذیری یا ظرفیت پایگاه داده | سامانههای دادهمحور |
در خوشه توزیع بار، مؤلفهای در مسیر درخواستها قرار میگیرد و ترافیک را بر اساس سیاست مشخص به سرورهای آماده هدایت میکند. برای درک نقش این مؤلفه، پرسش «LoadBalancer چیست» اهمیت دارد. توزیعکننده بار میتواند بر مبنای تعداد اتصال، ظرفیت یا نتیجه بررسی سلامت تصمیم بگیرد، اما مسئولیت هماهنگی دادههای پایگاه داده را ندارد.
خوشههای HPC در جهت دیگری حرکت میکنند: تقسیم یک مسئله محاسباتی به وظایف کوچکتر و اجرای آنها روی چند ماشین. در خوشه پایگاه داده نیز انتخاب میان تکثیر داده، گرههای خواندنی و سازوکار انتخاب نویسنده اصلی به الزامات سازگاری و کارایی وابسته است.
معماری Active-Active و Active-Passive چه تفاوتی دارند؟
مدل فعالیت نودها یکی از تصمیمهای بنیادین طراحی است. این انتخاب بر ظرفیت موردنیاز، الگوی بازیابی، هزینه و مدیریت وضعیت برنامه اثر میگذارد. در معماری رایانش ابری نیز همین الگوها در سطح ماشین مجازی، سرویس و پایگاه داده دیده میشوند، اما اجرای آنها به قابلیتهای ارائهدهنده زیرساخت وابسته است.
معماری Active-Active
در این حالت، دو یا چند نود همزمان به درخواستهای عملیاتی پاسخ میدهند. ظرفیت قابل استفاده میان اعضا توزیع میشود و در صورت خروج یک عضو، نودهای باقیمانده باید توان جذب بار اضافی را داشته باشند. این شیوه برای سرویسهای بدون وضعیت، از جمله بسیاری از APIها، مناسب است. در برنامههای دارای نشست یا داده مشترک، هماهنگی وضعیت باید جداگانه طراحی شود.
معماری Active-Passive
یک نود سرویس اصلی را ارائه میدهد و عضو دیگر آماده پذیرش مسئولیت هنگام خرابی است. مزیت این روش، سادهتر شدن برخی مسائل همزمانی است. در مقابل، بخشی از ظرفیت معمولاً در شرایط عادی استفاده مستقیم ندارد. زمان راهاندازی سرویس روی نود جایگزین و شیوه دسترسی به داده، بر مدت وقفه اثر میگذارند.
هیچکدام از این دو الگو ذاتاً بدون قطعی نیستند. انتخاب مناسب باید با الگوی مصرف، توان نودهای باقیمانده و آزمون واقعی انتقال سرویس تعیین شود.
پیشنیازها و ریسکهای طراحی کلاستر
نخستین پیشنیاز، شناسایی وابستگیهای سرویس است. مسیر شبکه، DNS، فضای ذخیرهسازی، پایگاه داده و سامانه احراز هویت باید بررسی شوند. افزونگی در سطح سرور زمانی ارزش عملی دارد که خرابی یک مؤلفه مشترک، همه اعضا را همزمان از کار نیندازد. جداسازی نودها میان میزبانهای فیزیکی یا دامنههای خرابی مستقل، با توجه به سطح خدمت موردنیاز، میتواند ریسک را کاهش دهد.
Quorum و جلوگیری از Split-Brain
Quorum سازوکار تصمیمگیری درباره معتبر بودن ادامه فعالیت خوشه است. در بسیاری از پیادهسازیها، اکثریت رأیها باید در دسترس باشد. اگر ارتباط میان نودها قطع شود و هر بخش خود را مالک سرویس بداند، وضعیت Split-Brain شکل میگیرد. نتیجه احتمالی، ثبت همزمان داده ناسازگار است. برای جلوگیری از آن، از رأی شاهد (Witness)، سیاستهای Quorum و در برخی خوشهها Fencing برای ایزولهکردن نود مشکوک استفاده میشود.
پایش و حفاظت از دادهها
مدیریت سرور در ساختار خوشهای باید فراتر از بررسی روشن بودن ماشین باشد. تأخیر شبکه، وضعیت دیسک، خطاهای برنامه، موفقیت تکثیر داده و رویدادهای جابهجایی سرویس باید پایش شوند. دسترسی مدیریتی نیز باید محدود، ثبتشده و قابل ممیزی باشد. کلاستر جایگزین نسخه پشتیبان نیست. حذف اشتباه داده یا آلودگی اطلاعات میتواند میان نودهای همگامشده گسترش پیدا کند.
مراحل راهاندازی و آزمون کلاستر
پیادهسازی با نصب ابزار آغاز نمیشود. ابتدا باید مشخص شود چه میزان وقفه و از دست رفتن داده برای کسبوکار پذیرفتنی است. RTO حداکثر زمان هدف برای بازیابی سرویس و RPO میزان عقبرفت مجاز داده تا نقطه بازیابی را مشخص میکنند. این دو شاخص روی انتخاب روش تکثیر، فاصله نودها و بودجه اثر دارند.
مراحل اصلی اجرا به ترتیب عبارتاند از:
- نیازسنجی: بار کاری، وابستگیهای برنامه، ظرفیت اوج مصرف و دامنه خرابی قابل تحمل را ثبت کنید.
- انتخاب معماری: نوع خوشه، وضعیت نودها، شبکه و روش ذخیرهسازی را مطابق نیاز تعیین کنید.
- آمادهسازی زیرساخت: همگامسازی زمان، تنظیم دسترسیها، تفکیک شبکه و ارتباط امن میان اعضا را بررسی کنید.
- پیکربندی و استقرار: سازوکار بررسی سلامت، سیاست انتقال سرویس، Quorum و ثبت رویدادها را فعال کنید.
- آزمون خرابی: قطع نود، از دست رفتن ارتباط شبکه و اختلال فضای ذخیرهسازی را در شرایط کنترلشده آزمایش کنید.
برای برنامههای کانتینری، کوبرنتیز امکان زمانبندی پادها، حفظ تعداد نمونههای تعیینشده و انتقال بار از نمونه ناسالم را فراهم میکند. بااینحال، ارکستراسیون کانتینر جای طراحی صحیح پایگاه داده و ذخیرهسازی پایدار را نمیگیرد. موفقیت یک آزمون نیز کافی نیست. سناریوهای خرابی باید پس از تغییر زیرساخت، ارتقای نرمافزار و افزایش بار تکرار شوند.
هزینهها، مزایا و معیار انتخاب راهکار
مهمترین مزیت خوشهبندی، کاهش وابستگی سرویس به یک ماشین است. در برخی معماریها، افزایش ظرفیت و انجام تعمیرات با اختلال کمتر نیز امکانپذیر میشود. در برابر این مزایا، هزینه سختافزار یا منابع ابری، مجوز نرمافزار، شبکه افزونه و نیروی متخصص قرار دارد. پیچیدگی عیبیابی نیز افزایش مییابد، زیرا مشکل ممکن است از ارتباط نودها یا ناسازگاری وضعیت داده ناشی شود.
برای یک وبسایت عمدتاً بدون وضعیت، چند سرور برنامه پشت توزیعکننده بار میتوانند راهحل عملی باشند. برای سامانه تراکنشی، سازوکار سازگاری پایگاه داده و جلوگیری از نوشتن همزمان ناسازگار اولویت بالاتری دارد. در بارهای محاسباتی سنگین، معیار اصلی ممکن است توان پردازش موازی باشد، نه جابهجایی سریع سرویس.
سازمانهایی که به جداسازی شبکه و کنترل بیشتر بر منابع نیاز دارند، میتوانند خدمات ابر خصوصی را نیز در ارزیابی زیرساخت قرار دهند. بااینحال، نام سرویس یا تعداد ماشینها معیار کافی برای انتخاب نیست. تعهد سطح خدمت، محل قرارگیری نودها، شیوه پشتیبانگیری و نتایج آزمون بازیابی باید پیش از خرید بررسی شوند.
جمعبندی
کلاسترینگ سرور زمانی ارزش عملی ایجاد میکند که معماری آن با ریسک واقعی کسبوکار هماهنگ باشد. برای سرویسهای وب، توزیع بار و ظرفیت مازاد اهمیت دارد. در سامانههای دادهمحور، سازگاری اطلاعات و کنترل مالکیت سرویس تعیینکننده است. تصمیم نهایی باید بر پایه RTO، RPO، نقاط شکست مشترک و آزمون ثبتشده سناریوهای خرابی گرفته شود، نه تعداد نودها.
سؤالات متداول
آیا کلاسترینگ از تمام قطعیهای سرور جلوگیری میکند؟
خیر. خرابی مشترک شبکه، ذخیرهسازی یا نرمافزار میتواند چند نود را همزمان مختل کند.
آیا برای ساخت کلاستر به سرور فیزیکی نیاز است؟
خیر. کلاستر را میتوان با ماشینهای مجازی نیز اجرا کرد، مشروط به طراحی درست دامنههای خرابی.
آیا کلاستر جایگزین نسخه پشتیبان میشود؟
خیر. خوشهبندی بر تداوم سرویس تمرکز دارد، اما بازیابی داده حذفشده یا آسیبدیده به پشتیبان نیاز دارد.
نشانی ایمیل شما منتشر نخواهد شد. بخشهای موردنیاز علامتگذاری شدهاند *
نظر دهید تعداد کاراکتر مانده: 300