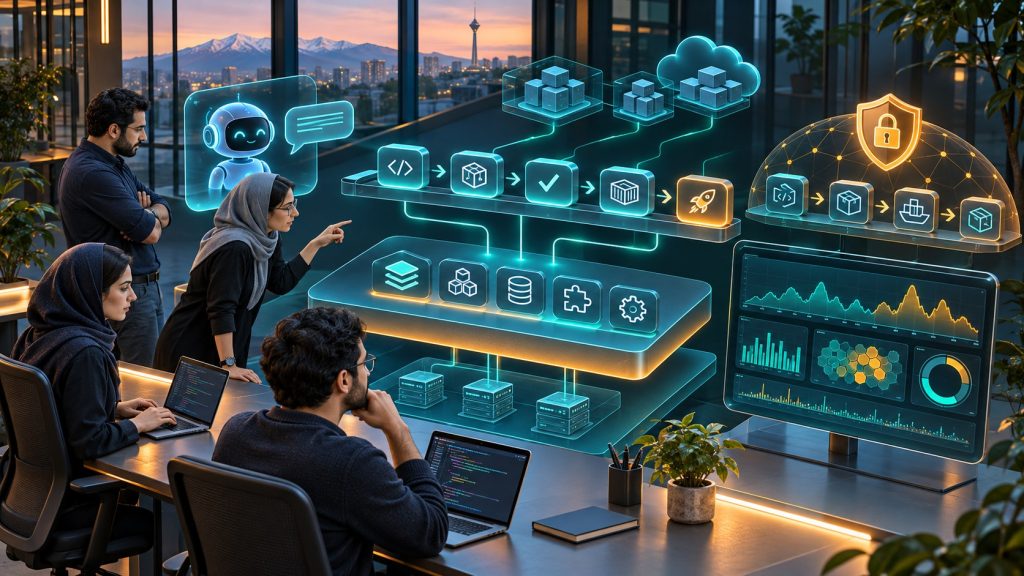
فرض کنید تیم توسعه میخواهد یک سرویس تازه راهاندازی کند. امروز ممکن است برای ساخت مخزن، تنظیم CI/CD، گرفتن دسترسی و اضافهکردن مانیتورینگ، چهار درخواست جداگانه ثبت کند. در مدلی که بسیاری از تیمهای پلتفرم دنبال میکنند، توسعهدهنده یک قالب آماده انتخاب میکند و سرویس با مسیر انتشار، پایش و کنترلهای اولیه ساخته میشود. تیم دواپس هم همان مسیر مشترک را نگهداری و بهبود میدهد. گروه مهندسی پلتفرم CNCF
این تغییر یکی از جهتهای آیندهٔ دواپس را نشان میدهد. ارزش کار تیم بیش از پیش در این دیده میشود که توسعهدهنده چقدر مستقل و قابلاتکا میتواند نرمافزار را به محیط عملیاتی برساند. وقتی سرعت تولید تغییر بالا میرود، تیم باید بتواند کیفیت آن را بسنجد و هنگام اختلال سریعتر بفهمد چه اتفاقی افتاده است. گزارش DORA دربارهٔ توسعهٔ نرمافزار با کمک هوش مصنوعی
۱. مهندسی پلتفرم، کارهای تکراری دواپس را به خدمات داخلی تبدیل میکند
وقتی چند تیم برای ساخت و انتشار سرویسهای مشابه به زیرساخت درخواست میدهند، میشود بخشی از آن فرایند را به یک قابلیت خودخدمت تبدیل کرد. مثلاً قالب ایجاد یک API جدید میتواند مخزن، Pipeline تست، تنظیمات استقرار و داشبورد اولیه را در یک مسیر مشترک آماده کند. تیم توسعه در همان مسیر کار میکند و تیم پلتفرم کنترلهایی مثل حدود دسترسی و سیاست انتشار را در آن قرار میدهد.
گاهی یک مخزن قالب و چند Pipeline قابل استفادهٔ مجدد برای شروع کافی است. معیار موفقیت این است که ببینیم آیا تیمها سرویس جدید را با رفتوبرگشت کمتر راهاندازی میکنند و آیا میتوانند خودشان آن را منتشر و پایش کنند. اندازهٔ پلتفرم باید با تعداد تیمها و نیازهای مشترکشان رشد کند. الگوهای پلتفرم داخلی در CNCF
۲. عاملهای هوش مصنوعی به عیبیابی نزدیکتر میشوند
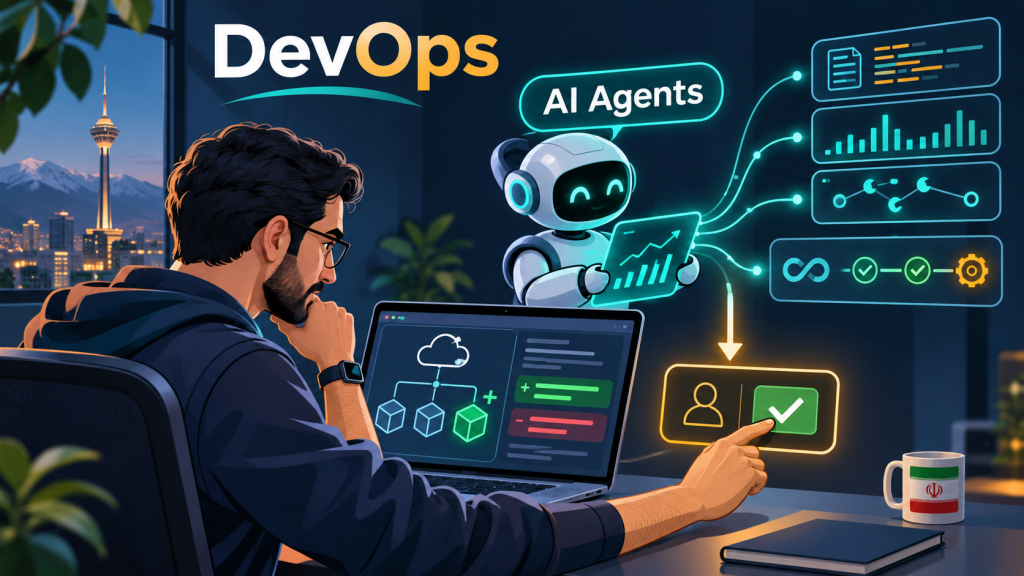
یکی از کاربردهای عملی AI Agent در دواپس، جمعآوری شواهد بعد از شکست یک Pipeline یا دریافت هشدار است. برای نمونه، وقتی یک Job در GitLab شکست میخورد، عامل میتواند لاگ را بخواند، تست ناموفق را پیدا کند و نتیجه را همراه با خط شاهد و لینک Job در Merge Request گزارش دهد. توسعهدهنده از همان گزارش میتواند بررسی را شروع کند.
ارزش این کار به کیفیت داده و فرایند موجود بستگی دارد. اگر لاگ ناقص باشد یا معلوم نباشد کدام نسخه در محیط عملیاتی اجرا میشود، عامل شواهد محدودی دارد. پژوهش DORA در سال ۲۰۲۵ نشان میدهد هوش مصنوعی میتواند اثر نقاط قوت و ضعف فرایند موجود را بیشتر کند. اگر بررسی اولیهٔ رخداد را به عامل میسپاریم، میتوانیم زمان رسیدن مهندس به اولین شاهد قابل بررسی و تعداد گزارشهایی را که به اصلاح نیاز دارند بسنجیم. گزارش DORA · نمونهٔ تحلیل خطای GitLab با AI Agent و MCP
۳. امنیت انتشار به منشأ فایل و تصویر کانتینر هم میپردازد
هنگام انتشار یک تصویر کانتینر، تیم عملیات باید بتواند پاسخ دهد که این تصویر از کدام commit ساخته شده و کدام فرایند ساخت آن را تولید کرده است. هرچه تعداد سرویسها و دفعات انتشار بیشتر شود، پاسخدادن دستی به این سؤال دشوارتر میشود.
استاندارد SLSA برای ثبت منشأ خروجی ساخت، چارچوب مشخصی ارائه میدهد. یک کاربرد عملی آن این است که فرایند استقرار بررسی کند تصویر کانتینر از مسیر ساخت مورد اعتماد سازمان آمده است. با این کار، تیم قبل از انتشار شواهدی در اختیار دارد که میتواند بر اساس آن تصمیم بگیرد. مشخصات رسمی SLSA
۴. مشاهدهپذیری به تشخیص اثر اختلال کمک میکند
بالارفتن مصرف CPU یا افزایش تعداد خطاها شروع بررسی است. برای تصمیم عملی باید بدانیم کدام سرویس آسیب دیده، چه تعداد درخواست درگیر شده و چه تغییری نزدیک به زمان شروع اختلال رخ داده است. متریکها روند را نشان میدهند، لاگها جزئیات رخداد را ثبت میکنند و Trace مسیر درخواست را بین سرویسها قابل پیگیری میکند. ارتباط این دادهها با نام سرویس و اطلاعات نسخه به محدودکردن دامنهٔ بررسی کمک میکند. مستندات سیگنالهای OpenTelemetry
اگر خطای سرویس پرداخت بعد از یک انتشار بالا رفت، تیم میتواند نرخ خطا و حجم درخواست را در بازهٔ قبل و بعد مقایسه کند و سپس Trace درخواستهای ناموفق را بررسی کند. این بررسی نشان میدهد آیا بازگشت نسخه ارزش بررسی دارد یا باید ابتدا یک وابستگی، مثل سرویس احراز هویت، را بررسی کرد.
نقش مهندس دواپس در این مسیر چطور تغییر میکند؟
انتظار میرود در تیمهایی که انتشار و پایش را استاندارد میکنند، سهم کار دستی کمتر شود و وقت بیشتری به طراحی فرایند تحویل، نگهداری پلتفرم داخلی و حل مشکلاتی که چند سرویس را درگیر میکنند اختصاص پیدا کند. دانش Linux، شبکه، CI/CD و زیرساخت همچنان در همین کارها بهکار میآید. مهندس دواپس میتواند مسیر انتشار یک سرویس را طراحی کند و آن را طوری در اختیار تیمها بگذارد که سرویس بعدی هم از همان الگو استفاده کند.
اگر بیشتر تأخیرها هنگام گرفتن دسترسی و آمادهسازی محیط رخ میدهد، روی همان مسیر کار کنید و زمان راهاندازی سرویس را بسنجید. اگر تیم پس از هر انتشار دیر متوجه اختلال میشود، اول پایش نسخه و مسیر بازیابی را بهبود دهید. پس از آن، دادهٔ بهتری هم برای خودکارسازی عیبیابی خواهید داشت.
اگر میخواهید مسیر انتشار، مانیتورینگ یا عملیات زیرساخت سازمانتان را بررسی کنید، همکاری میتواند از یک سرویس و یک مسئلهٔ مشخص شروع شود.
نشانی ایمیل شما منتشر نخواهد شد. بخشهای موردنیاز علامتگذاری شدهاند *
نظر دهید تعداد کاراکتر مانده: 300