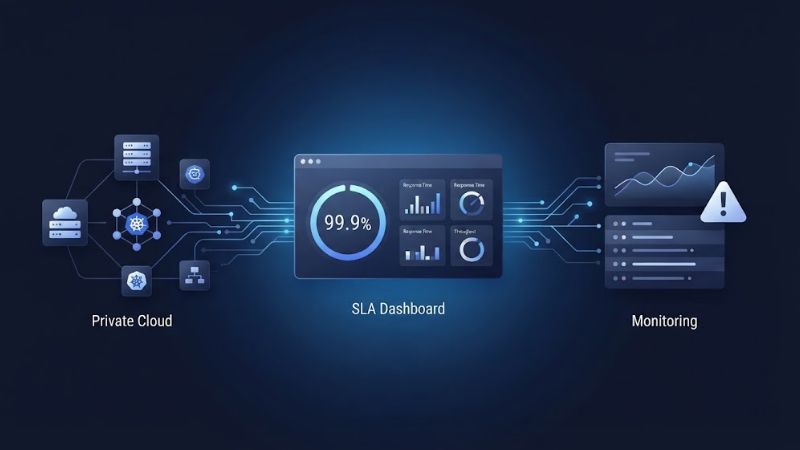
یک SLA زمانی ارزش واقعی پیدا میکند که بتوان از روی دادههای سیستم گفت سرویس دقیقاً چه سطحی از دسترسپذیری، سرعت و ظرفیت را ارائه میدهد. اجزای اصلی مدیریت SLA این چارچوب را از یک توافق کلی به مجموعهای از معیارها و فرآیندهای قابل اندازهگیری تبدیل میکنند؛ از تعریف SLO و سنجش Availability و Latency تا بررسی MTTR، MTBF و نحوه گزارشدهی عملکرد. در این مقاله از دواپس ایران، هر یک از این مؤلفهها را از دید مهندسی بررسی میکنیم و به نقش مانیتورینگ در پایش خودکار آنها میپردازیم. سپس ارتباط این اجزا با مدیریت زیرساخت ابر خصوصی، کنترل منابع اختصاصی و پاسخگویی به نیازهای عملیاتی سازمان را بررسی خواهیم کرد.
مدیریت SLA چیست و چه ارکانی دارد؟
مدیریت سطح خدمات (Service Level Agreement Management) چارچوبی برای تعریف، اندازهگیری و کنترل کیفیت سرویس میان ارائهدهنده و مصرفکننده است. SLA مشخص میکند یک سرویس باید با چه سطحی از دسترسپذیری، عملکرد، پشتیبانی و پاسخگویی ارائه شود و در صورت عبور از محدوده توافقشده، چه فرآیندی برای مدیریت آن اجرا شود.
در محیطهای Enterprise، SLA نباید فقط یک سند قراردادی باشد. این توافق باید به شاخصهای فنی، ابزارهای پایش و فرآیندهای عملیاتی متصل شود تا تیمها بتوانند وضعیت واقعی سرویس را اندازهگیری و درباره بهبود آن تصمیمگیری کنند.
تفاوت SLA، SLO و SLI
برای اجرای صحیح مدیریت SLA، ابتدا باید نقش هر یک از این سه مفهوم در اندازهگیری و تعیین سطح خدمات مشخص شود.
- شاخص سطح خدمات (Service Level Indicator – SLI): معیاری است که وضعیت واقعی سرویس را اندازهگیری میکند؛ مانند نرخ خطا، زمان پاسخ یا درصد درخواستهای موفق.
- هدف سطح خدمات (Service Level Objective – SLO): سطحی است که تیم فنی برای یک شاخص مشخص بهعنوان هدف تعیین میکند؛ برای مثال، دسترسپذیری ۹۹.۹ درصد در یک بازه زمانی مشخص.
- توافقنامه سطح خدمات (Service Level Agreement – SLA): تعهد رسمی میان طرفین است که سطح سرویس، اهداف مورد انتظار، شرایط پشتیبانی و الزامات گزارشدهی را مشخص میکند.
برای مقایسه سریع، جدول زیر نقش هر مفهوم و نمونهای از معیار مربوط به آن را نشان میدهد:
| مفهوم | نقش | نمونه معیار |
|---|---|---|
| SLI | اندازهگیری وضعیت واقعی سرویس | نرخ خطا، زمان پاسخ |
| SLO | تعیین هدف فنی سرویس | دسترسپذیری ۹۹.۹٪ |
| SLA | تعریف تعهدات سرویس | سطح پشتیبانی و کیفیت توافقشده |
ارکان اصلی و قابل اجرا SLA
یک SLA موثر باید اجزای زیر را مشخص کند:
- محدوده سرویس: تعیین سرویسها و اجزای تحت پوشش.
- شاخصهای عملکردی: مانند Availability، Latency و نرخ خطا.
- سطح پشتیبانی: زمان پاسخگویی و فرآیند مدیریت رخدادها.
- روش اندازهگیری: منبع دادهها و نحوه گزارشدهی عملکرد.
- شرایط استثنا: محدودیتها و رخدادهایی که خارج از تعهد سرویس هستند.
در معماریهای پیچیده مانند Kubernetes و زیرساختهای ابری، SLA باید با واقعیت فنی سیستم هماهنگ باشد. تعریف تعهد بدون توجه به وابستگی سرویسها، ظرفیت زیرساخت و فرآیند بازیابی، تصویر دقیقی از پایداری ارائه نمیدهد.
مدیریت SLA زمانی اثربخش است که به بخشی از چرخه مهندسی سرویس تبدیل شود و میان اهداف کسبوکار و معیارهای فنی ارتباط ایجاد کند. در بخش بعدی، شاخصهای کلیدی ارزیابی عملکرد سرویس و روش اندازهگیری آنها بررسی میشوند.
بیشتر بخوانید: کوبرنتیز (Kubernetes) چیست و چه کاربردی دارد؟
ارزیابی شاخصهای کلیدی کارایی (Availability، Latency و Throughput)
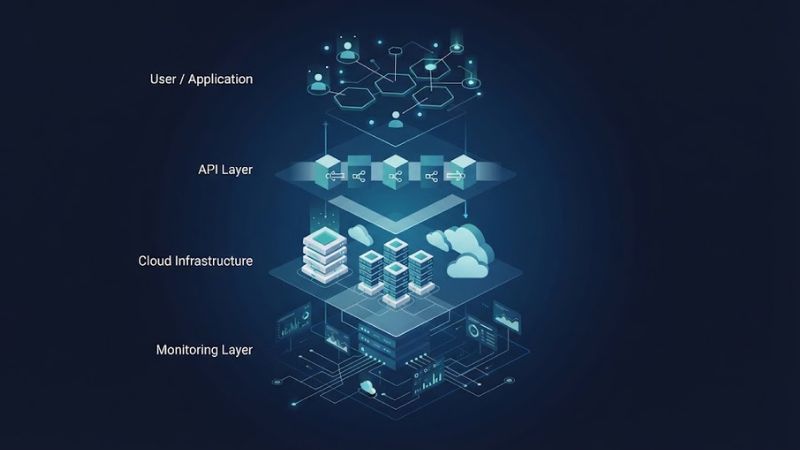
برای ارزیابی کارایی یک سرویس، سه شاخص اصلی را باید همزمان دید: میزان دسترسپذیری، سرعت پاسخگویی و ظرفیت پردازش. کنار هم گذاشتن این معیارها، تصویر دقیقتری از رفتار سرویس در شرایط عادی و زمان افزایش بار میدهد.
- دسترسپذیری (Availability)
مشخص میکند سرویس در چه درصدی از زمان در دسترس بوده است. مقدار هدف این شاخص باید با اهمیت سرویس، نیاز کسبوکار و میزان تحمل قطعی هماهنگ باشد.
- تاخیر (Latency)
زمان لازم برای پاسخگویی به هر درخواست را نشان میدهد. بررسی P95 و P99 کمک میکند رفتار سرویس هنگام افزایش بار را دقیقتر ببینیم؛ مخصوصاً زمانی که میانگین، تصویر کاملی از تجربه کاربران نمیدهد.
- نرخ پردازش (Throughput)
تعداد درخواستها یا حجم دادهای است که سیستم در واحد زمان پردازش میکند. این شاخص در کنار Latency و نرخ خطا بررسی میشود تا ظرفیت واقعی سرویس مشخص شود.
روشهای سنجش پایداری و بازیابی از خرابی (MTTR و MTBF)
برای ارزیابی پایداری یک سرویس، باید دو سؤال مشخص را پاسخ داد: خرابیها با چه فاصلهای رخ میدهند و بعد از هر خرابی، سرویس چقدر سریع به وضعیت عادی برمیگردد؟ MTBF و MTTR برای پاسخ به همین دو سؤال استفاده میشوند.
- میانگین زمان بین خرابیها (MTBF): فاصله متوسط بین خرابیهای سرویس را نشان میدهد. بررسی روند این شاخص کمک میکند مشخص شود آیا یک مشکل بهصورت تکرارشونده رخ میدهد یا پایداری سیستم در حال بهبود است.
- میانگین زمان بازیابی (MTTR): زمان متوسط موردنیاز برای بازگرداندن سرویس پس از خرابی است. این شاخص فقط به مدت اختلال وابسته نیست؛ سرعت تشخیص، کیفیت Runbookها، دسترسی به لاگ و متریک و میزان آمادگی تیم در آن اثر مستقیم دارد.
در یک محیط Production، افزایش MTBF معمولاً به بررسی ریشهای خرابیها و حذف عوامل تکرارشونده نیاز دارد، در حالی که کاهش MTTR بیشتر به بهبود فرآیند تشخیص، پاسخ و بازیابی وابسته است. بررسی همزمان این دو شاخص، تصویر عملیتری از وضعیت پایداری سرویس ارائه میدهد.
ارکان حقوقی و مالی در مدیریت سطح خدمات
SLA زمانی قابل اتکا است که تعهدات فنی، پیامدهای مالی و نحوه گزارش عملکرد در آن شفاف باشد. این بخش مشخص میکند در صورت افت سطح سرویس، چه چیزی اندازهگیری میشود، مسئولیتها چگونه تعیین میشوند و جبران خسارت با چه معیاری انجام خواهد شد.
- سیاستهای جریمه: باید شرایط اعمال جریمه، آستانه نقض SLA و نحوه محاسبه آن از قبل مشخص باشد. معیار مبهم معمولاً در زمان رخداد به اختلاف میان طرفین منجر میشود.
- جبران خسارت: نوع و سقف جبران خسارت باید متناسب با سطح سرویس و اثر اختلال تعیین شود. در سرویسهای حیاتی، تعریف اعتبار خدمات، بازپرداخت بخشی از هزینه یا سازوکارهای مشابه میتواند بخشی از توافق باشد.
- شفافیت در گزارشدهی: دادههای مربوط به Availability، زمان اختلال و رخدادهای سرویس باید بر اساس معیارهای مشخص و قابل بررسی گزارش شوند. استفاده از دادههای ثبتشده در سیستم مانیتورینگ، امکان ارزیابی مستقل عملکرد SLA را فراهم میکند.
شفاف بودن این موارد، SLA را از یک تعهد کلی به چارچوبی قابل اندازهگیری برای مدیریت مسئولیت، هزینه و کیفیت سرویس تبدیل میکند.
نقش ابزارهای مانیتورینگ در پایش خودکار SLA
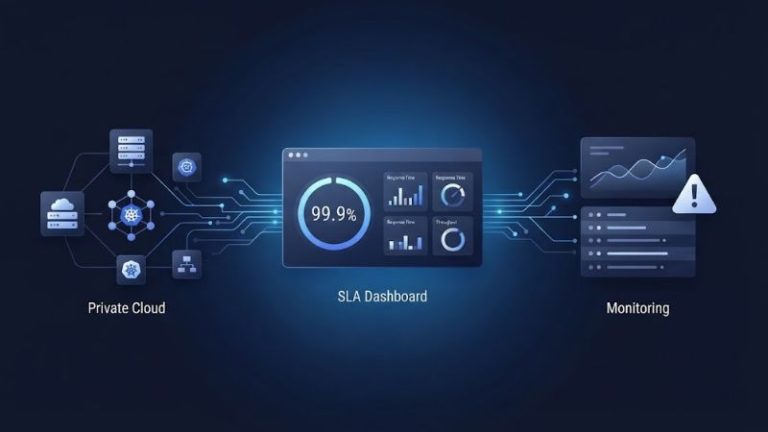
ابزارهای مانیتورینگ، شاخصهای SLA را از دادههای پراکنده زیرساخت به معیارهای قابل پایش تبدیل میکنند. متریکها، لاگها و رخدادها در کنار هم کمک میکنند تغییرات Availability، Latency و نرخ خطا بهصورت مداوم بررسی شوند و افت عملکرد پیش از نقض SLA شناسایی شود.
این دادهها پایه شکلگیری قابلیت مشاهدهپذیری (Observability) در سیستمها هستند. برای درک بهتر این مفهوم، بررسی اینکه Observability چیست و چگونه دادههای مختلف سرویس را برای تحلیل وضعیت سیستم کنار هم قرار میدهد، اهمیت دارد.
متریکها روند سلامت و کارایی سرویس را نشان میدهند و لاگها جزئیات لازم برای تحلیل علت خطا را فراهم میکنند. ترکیب این دادهها، مخصوصاً در رخدادهایی که افت عملکرد بهتدریج شکل میگیرد، امکان تشخیص الگوهای غیرعادی و ریشهیابی سریعتر را فراهم میکند.
در پایش خودکار SLA، عبور هر شاخص از آستانه تعیینشده میتواند به ایجاد هشدار، ثبت رخداد و اجرای فرآیند پاسخ منجر شود. همین دادهها برای بررسی نقض SLA و گزارشگیری دورهای نیز استفاده میشوند و فاصله میان پایش فنی و تعهدات سرویس را کاهش میدهند.
بیشتر بخوانید: بهترین ابزارهای مانیتورینگ DevOps برای بهبود عملکرد تیمها
اهمیت پیادهسازی مدیریت SLA در زیرساخت ابر خصوصی
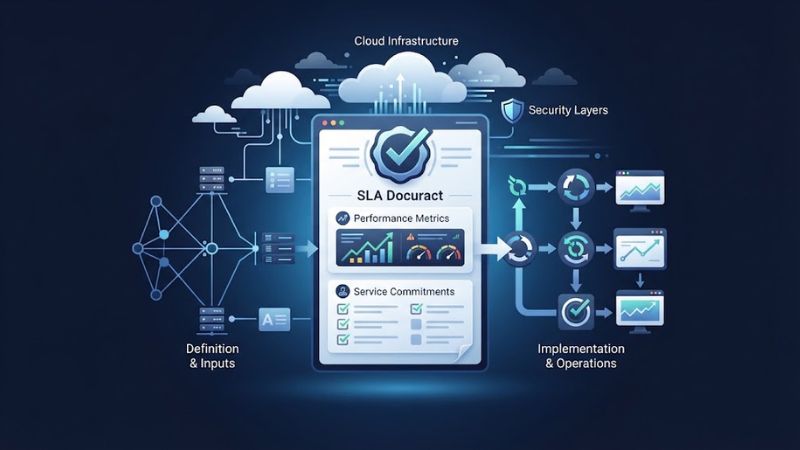
در زیرساخت ابر خصوصی، مدیریت SLA به سازمان کمک میکند ظرفیت، پایداری و کیفیت سرویس را در یک چارچوب مشخص کنترل کند. زمانی که Availability، Latency، Throughput، MTTR و MTBF در کنار سیاستهای گزارشدهی و جبران خسارت قرار میگیرند، وضعیت سرویس از یک ارزیابی کلی به مجموعهای از معیارهای قابل اندازهگیری تبدیل میشود.
این رویکرد در محیطهایی که منابع اختصاصی برای سرویسهای حیاتی در نظر گرفته شدهاند اهمیت بیشتری پیدا میکند. برای درک بهتر نحوه طراحی این محیطها، شناخت اینکه معماری رایانش ابری چیست و چگونه منابع پردازشی، شبکه و ذخیرهسازی را سازماندهی میکند، اهمیت دارد. انتخاب معماری مناسب میتواند روی نحوه تخصیص منابع، مقیاسپذیری و کیفیت ارائه سرویس اثر مستقیم داشته باشد.
در چنین شرایطی، خدمات ابری خصوصی زمانی ارزش عملیاتی بیشتری پیدا میکنند که مدیریت منابع و سطح خدمات بهصورت یکپارچه دیده شوند. حاصل این مدل، کنترل دقیقتر زیرساخت، شفافیت بیشتر در عملکرد سرویس و امکان پاسخگویی بهتر به نیازهای فنی و عملیاتی سازمان است.
جمعبندی
مدیریت سطح خدمات زمانی به یک ابزار واقعی برای کنترل زیرساخت تبدیل میشود که تعهدات سرویس به شاخصهای قابل اندازهگیری، فرآیندهای عملیاتی و دادههای مانیتورینگ متصل باشند. در این مدل، هر افت عملکرد قابل مشاهده و قابل پیگیری است و تیم فنی میتواند بهجای واکنشهای موردی، بر اساس داده درباره پایداری، ظرفیت و نحوه بازیابی تصمیم بگیرد.
شناخت اجزای اصلی مدیریت SLA کمک میکند این چارچوب از سطح یک توافق قراردادی فراتر برود و به بخشی از معماری و عملیات زیرساخت تبدیل شود؛ بهویژه در ابر خصوصی که کنترل منابع، کیفیت سرویس و پاسخگویی فنی اهمیت بالاتری پیدا میکند.
برای سازمانهایی که بهدنبال ارزیابی دقیق وضعیت زیرساخت و شناسایی نقاط ضعف SLA هستند، بررسی معماری، متریکها و فرآیندهای عملیاتی توسط یک تیم متخصص میتواند تصویر شفافتری از وضعیت موجود و مسیر بهبود ارائه دهد.
سوالات متداول
آیا SLA برای همه سرویسهای سازمان باید یکسان باشد؟
خیر. سطح تعهد باید بر اساس اهمیت کسبوکاری، حساسیت سرویس و پیامد اختلال تعیین شود.
بازبینی SLA هر چند وقت یکبار انجام شود؟
بهتر است SLA در بازههای مشخص و همچنین پس از تغییرات مهم معماری یا سطح مصرف بازبینی شود.
چه کسی مسئول نگهداری و بهروزرسانی SLA است؟
معمولاً مالک سرویس با مشارکت تیم فنی، عملیات و ذینفعان کسبوکار مسئولیت آن را بر عهده دارد.



نشانی ایمیل شما منتشر نخواهد شد. بخشهای موردنیاز علامتگذاری شدهاند *
نظر دهید تعداد کاراکتر مانده: 300